이 블로그에 올린 백테스트·시뮬레이션 글 16편을 처음부터 다시 점검했다. 각 글의 코드를 읽으면서 흔히 생기는 오류(미래 정보 사용, 시작일 불일치, 비용 누락, 분할 보정, 생존 편향 표기)를 확인했고, 문제가 보이는 경우에만 다시 돌렸다. 먼저 결론부터 말하면, 데이터 오류 하나가 국내 백테스트 글 네 편의 수치를 바꿨고, 그중 한 편은 결론의 일부가 달라졌다. 나머지 글은 결론이 그대로였다. 앞서 정리한 데이터 오류 6가지에 이어지는 일곱 번째 오류와, 점검하면서 함께 찾은 작은 문제들을 기록해 둔다.
어떻게 점검했나
| 대상 | 백테스트·시뮬레이션 글 16편과 그 코드 |
| 1단계: 코드 읽기 | 재무 데이터를 공시 이후에만 쓰는지, 신호와 체결 시점이 맞는지, 전략과 비교 대상의 시작일이 같은지, 비용과 세금이 들어갔는지, 분할 보정이 맞는지, 한계가 글에 적혀 있는지 |
| 2단계: 재실행 | 1단계에서 문제가 의심되는 경우에만 원래 코드를 그대로 두고, 고친 데이터로 다시 돌려 글의 수치와 비교했다 |
오류 7. 가격은 분할 보정이 되어 있는데, 거래량은 아니었다
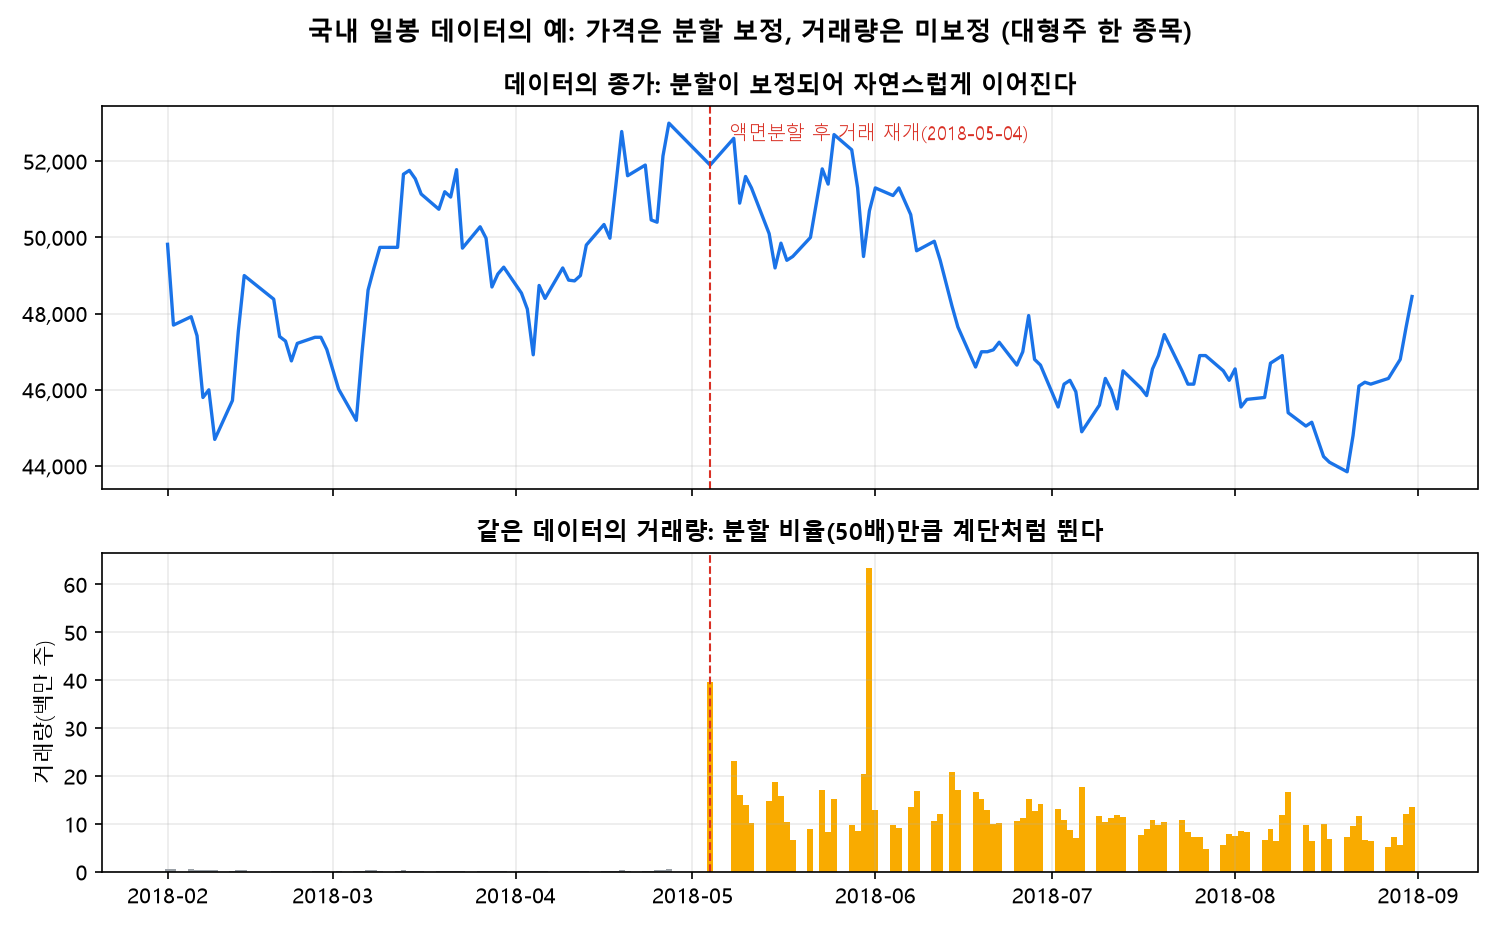
증상: 미너비니 방식 국내 백테스트의 진입 조건 중 하나가 "거래량이 50일 평균의 1.5배 이상"이다. 엔진을 읽다가, 액면분할 종목의 거래량이 어떻게 처리되는지 확인해 본 적이 없다는 것을 깨달았다.
원인: 국내 일봉 데이터는 가격은 분할에 맞춰 과거 가격까지 조정되어 있었지만, 거래량은 조정되지 않은 원래 숫자였다. 2018년 5월에 50대 1로 분할한 대형주를 보면, 분할 전 하루 거래량이 약 23만 주였는데 분할 후 첫날 약 3,956만 주가 됐다. 가격 그래프는 매끄럽게 이어지는데 거래량만 계단처럼 뛴다.
영향: 이 문제는 두 가지 경로로 결과를 바꿨다.
- 분할 직후 가짜 신호: 분할 직후 거래량이 과거 평균보다 수십 배 크게 계산되어, 몇 주 동안은 "거래량을 동반한 돌파" 조건을 거의 공짜로 통과했다.
- 대상군 왜곡: 거래대금(종가 × 거래량)으로 대상 종목을 고르는 글에서는, 분할 전 거래대금이 실제보다 작게 계산되어 대상군에서 빠졌다. 병합은 반대로 작용한다.
찾는 방법: 분할이나 병합을 할 때는 보통 며칠간 거래가 정지된다. 그래서 거래량이 0인 날이 이틀 이상 이어진 뒤, 거래량 수준이 3배 이상 커지거나 3분의 1 이하로 줄어든 경우를 찾았다. 2,472종목에서 327종목, 715건이 걸렸다. 알려진 큰 분할(2018년, 2021년 대형주 분할 등)은 모두 잡혔다. 분할이 아닌 장기 거래정지 뒤 재개도 일부 섞여 있지만, 그런 구간도 거래량이 비정상이라 함께 처리하는 편이 안전하다고 판단했다.
# v: 한 종목의 일별 거래량 (pandas Series)
z = (v == 0)
grp = (z != z.shift()).cumsum()
for g, run in z.groupby(grp):
    if run.iloc[0] and len(run) >= 2:                    # 거래정지 2일 이상
        pos = v.index.get_loc(run.index[-1]) + 1          # 재개일
        before = v.iloc[max(0, pos - 45):pos]
        before = before[before > 0].tail(20).median()
        after = v.iloc[pos:pos + 20]
        after = after[after > 0].median()
        ratio = after / before
        if ratio >= 3 or ratio <= 1 / 3:                  # 거래량 수준이 계단처럼 바뀜
print(v.index[pos].date(), round(ratio, 1))대처: 찾아낸 재개일부터 60거래일 동안은 거래량을 쓰지 않도록 비워 두고 다시 돌렸다. 거래량에 배수를 곱해 이어 붙이는 방식으로도 돌려 봤는데 결과가 거의 같았다(미너비니 국내 기본 규칙 기준 18.9% 대 18.3%).
정정 결과
| 글 | 항목 | 정정 전 | 정정 후 | 결론 |
|---|---|---|---|---|
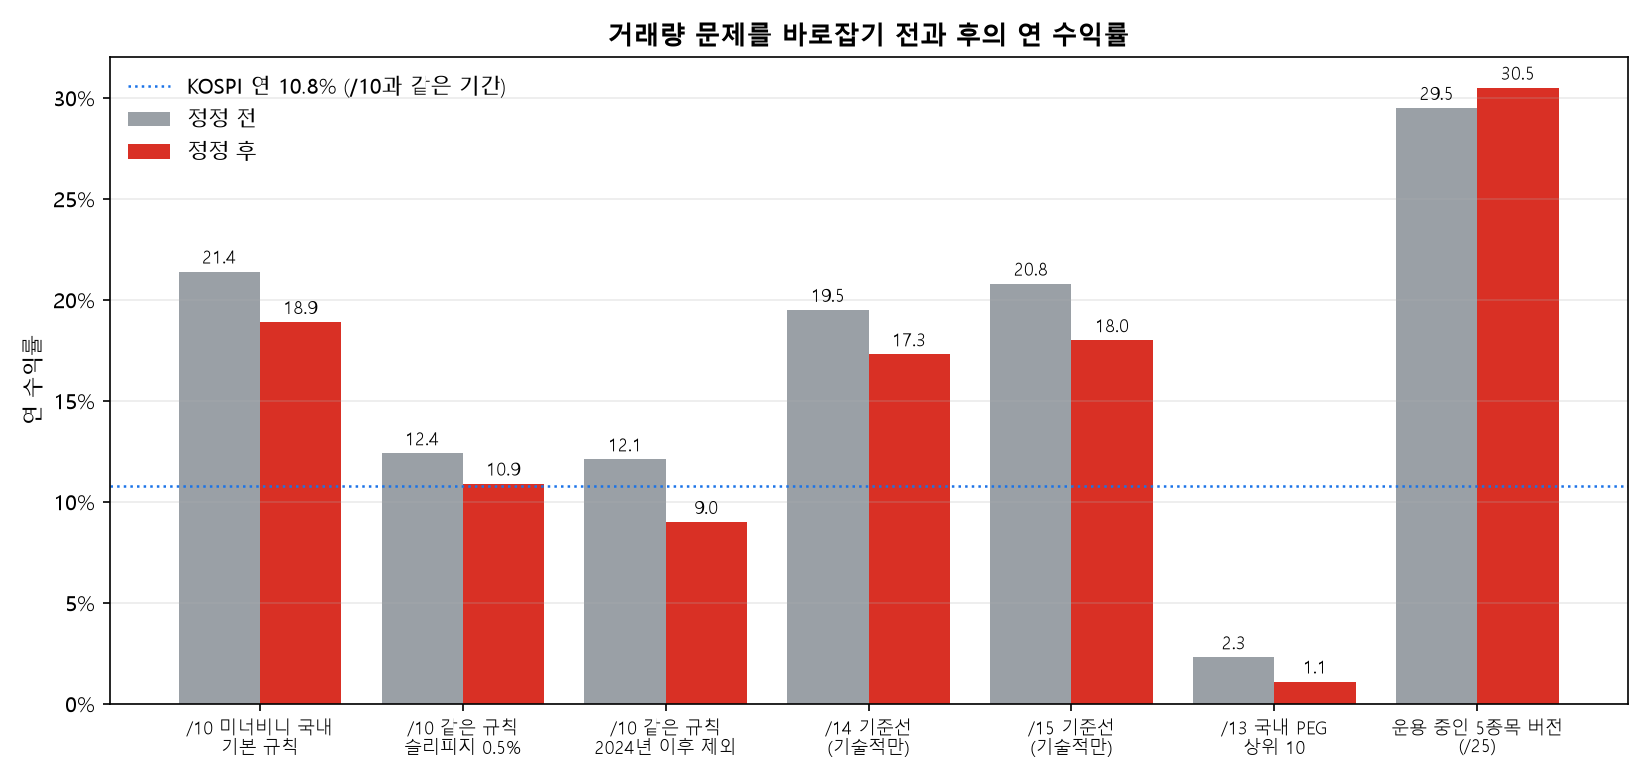
| /10 미너비니 국내 | 기본 규칙 연 수익률 | 21.4% | 18.9% | 유지. 다만 슬리피지 0.5%에서 10.9%로 KOSPI(10.8%)와 같아짐 |
| /14 연간 펀더멘털 | 기술적 조건만(기준선) | 19.5% | 17.3% | 필터 결론 유지. 우선순위 방식은 "효과 작음"에서 "작은 개선"으로 |
| /15 분기 펀더멘털 | 기술적 조건만(기준선) | 20.8% | 18.0% | 일부 변경: 우선순위 방식이 "효과 없음"에서 "작은 개선(+0.5~2.6%p)"으로 |
| /13 국내 PEG | PEG 상위 10종목 | 2.3% | 1.1% | 유지 (KOSPI 12.4%에 크게 못 미침) |
| /28 트레이딩의 전설 | 거래대금 급증 종목, 다음날 시가 | +0.373% | +0.372% | 영향 없음 |
- 펀더멘털 조건을 붙인 결과는 거의 그대로였다(0.1~0.7%p). 조건을 통과한 종목이 적어서, 분할 직후의 가짜 신호가 들어갈 자리가 작았기 때문이다.
- /15의 결론이 바뀐 이유는 기준선이 부풀려져 있었기 때문이다. 통과 종목을 먼저 사는 방식의 결과(16.6~20.6%)는 거의 그대로인데, 비교 대상이던 "기술적 조건만"이 20.8%에서 18.0%로 내려가면서 "효과 없음"이 "작은 개선"이 됐다. 비교 대상의 오류가 결론을 거꾸로 만들 수 있다는 좋은 예다.
- /28은 영향이 없었다. 이 글의 조건(거래대금이 20일 평균의 3배 이상 + 3% 이상 상승한 양봉)이 분할 직후 구간에서 걸린 경우가 전체 약 9만 8천 건 중 400건 안팎이라 평균에 거의 영향이 없었다.
같은 오류인데 방향이 반대로 나온 경우
흥미로운 결과가 하나 있었다. 같은 규칙을 5종목만 보유하도록 바꾼 버전(운용 중인 전략의 국내 설정)은 정정 후 연 29.5%에서 30.5%로 오히려 올랐다. 10종목 버전은 2.5%p 내려갔는데, 5종목 버전은 1%p 올라간 것이다.
즉 이 오류는 결과를 한쪽으로만 부풀린 것이 아니었다. 분할 직후의 가짜 신호가 들어가면 그날 어떤 종목이 먼저 잡히느냐가 바뀌고, 그 뒤의 매매가 줄줄이 달라진다. 보유 종목 수가 적을수록 이런 차이가 크게 증폭된다. 다르게 말하면, 이 전략의 결과는 데이터의 작은 차이에도 ±2~3%p씩 흔들릴 만큼 불안정하다. 정정된 숫자 하나를 믿기보다, 이 정도 폭의 오차가 있다고 보고 읽어야 한다.
함께 찾은 작은 문제들
| 문제 | 내용 | 영향과 조치 |
|---|---|---|
| 계산 캐시가 데이터를 구분하지 않음 | 국내 백테스트 엔진은 같은 설정을 반복해서 돌릴 때 빠르게 하려고 중간 계산을 저장해 둔다. 그런데 저장 열쇠가 설정값만이고 데이터는 포함하지 않았다. 데이터만 바꿔서 같은 설정으로 다시 돌리면 이전 데이터의 계산이 그대로 쓰인다. | 이번 재실행 전에 발견해서 매번 캐시를 비우도록 했다. 기존 글에는 영향이 없었다(한 번에 한 가지 데이터만 썼기 때문). |
| 가정 누락 | 무한매수법 글에서 매수를 기다리는 현금에 이자를 주지 않는다는 가정을 적지 않았다. 이 방법은 현금 비중이 커서 영향이 있을 수 있다. | 단기금리 이자를 넣어 다시 계산하니 연 0.3~1.2%p 차이였고 결론은 같았다. 두 글(/7, /8)에 가정을 추가했다. |
| 재현성 | 국내 PEG 글은 시가총액을 계산할 때 실행하는 날의 상장주식수를 새로 받아 온다. | 같은 코드, 같은 데이터로 며칠 뒤 다시 돌렸더니 2.3%가 아니라 1.8%가 나왔다. 실행 시점에 받은 외부 데이터는 저장해 두고 그것으로 계산해야 한다. |
| 집계 실수 | 트레이딩의 전설 글을 쓰면서, 표를 세로로 펼치는 함수가 빈 값을 지우지 않는 버전이라 건수가 실제보다 크게 찍혔다. 같은 작업에서 참/거짓 표의 자료형이 섞여 비율이 -30%로 나온 적도 있었다. | 비율이 음수일 수는 없어서 바로 알아챘다. 평균값에는 영향이 없었고 발행 전에 고쳤다. |
| 초기 데이터 불완전 | 국내 데이터의 2010~2013년 거래대금이 불완전해 보였다(조건에 걸리는 날이 연 6~13건뿐). | 미너비니 검증과 같은 2015년 6월 이후로만 분석했다. |
문제가 없었던 것
- 미국 가치 지표(/4, /5): 재무는 결산 후 150일이 지나야 쓰고, EPS 분할 보정(오류 1)도 적용되어 있었다.
- 미너비니 미국(/11): 미국 데이터는 거래량까지 분할 보정이 되어 있어서 이번 오류와 무관했다.
- ETF·은퇴 시뮬레이션, 환율·금 검증(/19~/21, /24, /26, /29): 시작일, 비용, 인출 시점, 부트스트랩 방식이 글의 설명과 맞았다.
체크리스트에 더할 것
- 가격뿐 아니라 거래량도 분할 기준이 맞는가? 분할 종목 하나를 골라 분할 전후의 거래량을 직접 그려 본다.
- 계산 캐시의 열쇠에 데이터가 포함되는가? 데이터를 바꿔 다시 돌렸는데 결과가 똑같다면 의심한다.
- 실행 시점에 받아 오는 외부 데이터(현재 주식 수, 현재 구성 종목 등)를 저장해 두었는가?
- 비교 대상(기준선)도 점검했는가? 전략이 아니라 기준선이 틀려도 결론이 뒤집힌다.
- 결과에 들어 있는 가정을 모두 글에 적었는가? 특히 결과를 불리하게 만드는 가정도.
정리
이번 점검으로 국내 백테스트 글 네 편의 숫자가 낮아졌다. 결론은 대부분 그대로였지만, 미너비니 국내 전략은 현실적인 비용을 넣으면 KOSPI와 비슷한 수준이라는 점이 더 분명해졌고, 펀더멘털 조건을 우선순위로 쓰는 방식은 "효과 없음"이 아니라 "작은 개선"이었다. 무엇보다 데이터 한 가지를 바로잡았을 때 결과가 ±2~3%p씩 움직였다는 사실이 중요하다. 백테스트의 숫자는 하나의 정답이 아니라, 이 정도는 흔들릴 수 있는 추정치로 읽어야 한다. 수정한 글에는 모두 맨 위에 정정 안내를 달았다.
※ 본 글은 개인 학습 기록이며 특정 종목의 매수·매도를 권유하지 않습니다. 코드는 설명을 위한 예시이며, 실제 적용 시 본인의 데이터 구조에 맞게 검증해야 합니다.
'투자 도구·자동화' 카테고리의 다른 글
| 백테스트용 무료 시장 데이터, 소스별로 무엇을 조심해야 할까: FinanceDataReader·pykrx·DART·SEC 함정 지도 (0) | 2026.10.06 |
|---|---|
| 연금저축·IRP 세액공제를 수익률로 환산하면 몇 %p일까? 납입 기간별 계산표 (0) | 2026.10.05 |
| DART OpenAPI로 상장사 재무제표(분기 포함)를 파이썬으로 받기: 차단당하지 않는 방법까지 (0) | 2026.10.01 |
| 백테스트 결과가 너무 좋을 때 먼저 의심할 것: 직접 겪은 데이터 오류 6가지 (0) | 2026.10.01 |